Quando as bases de dados crescem, o ciclo de importar, atualizar e esperar deixa de funcionar: as atualizações demoram horas, consomem memória da capacidade e os relatórios ficam defasados. O Direct Lake é a resposta do Microsoft Fabric para esse problema. Ele permite que o Power BI leia diretamente as tabelas Delta armazenadas no OneLake, com a velocidade do modo Import e sem copiar todo o volume de dados. Neste guia explicamos como ele funciona e como usá-lo para otimizar o acesso a grandes bases.
O que é o Direct Lake?
O Direct Lake é um modo de armazenamento de tabelas de modelos semânticos do Power BI, disponível no Microsoft Fabric. Ele foi otimizado para carregar grandes volumes de dados rapidamente na memória a partir de tabelas Delta disponíveis no OneLake, o repositório único para todos os dados de análise. Depois de carregado na memória, o modelo semântico oferece análise interativa de alto desempenho.
Ele é ideal para modelos que se conectam a grandes lakehouses, warehouses e outras fontes do Fabric com tabelas Delta, especialmente quando replicar todo o volume de dados para uma tabela Import é impraticável ou impossível.
Direct Lake x Import x DirectQuery
Os três modos diferem em como os dados chegam ao relatório:
- Import: copia os dados para dentro do modelo. Consultas rápidas (VertiPaq), mas a atualização gera uma cópia completa, o que pode ser demorado e consumir muitos recursos de fonte e de capacidade.
- DirectQuery: converte cada consulta DAX para a linguagem da fonte (por exemplo, SQL) e a executa no banco de origem. Os dados estão sempre atuais, mas o desempenho costuma ser inferior, pois a fonte raramente é otimizada para a carga de consultas de relatórios.
- Direct Lake: as consultas também são processadas pelo VertiPaq, como no Import, mas a "atualização" copia apenas metadados. Os dados são lidos do OneLake e carregados na memória apenas quando necessário.
| Característica | Direct Lake | Import | DirectQuery |
|---|---|---|---|
| Mecanismo de consulta | VertiPaq | VertiPaq | Fonte de dados |
| O que a atualização faz | Copia só metadados (segundos) | Copia todos os dados | Não se aplica |
| Grandes volumes sem atualização pesada | ✓ | — | ✓ |
| Baixa latência de dados | ✓ | — | ✓ |
| Licenciamento | Capacidade Fabric | Qualquer licença | Qualquer licença |
Os modos não são excludentes: um modelo pode combinar tabelas Direct Lake e tabelas Import (modelo composto), reunindo a escala do lago com a flexibilidade de fontes adicionais.
Como o Direct Lake funciona
Na atualização de um modelo Direct Lake, o Fabric faz o chamado enquadramento (framing): analisa os metadados da versão mais recente das tabelas Delta e atualiza as referências para os arquivos mais atuais no OneLake. É uma operação de baixo custo, que leva alguns segundos. Na hora da consulta, somente as colunas necessárias para responder ao visual são carregadas na memória.
Por isso, o Direct Lake mantém o desempenho do Import sem o ciclo pesado de atualização, e o volume de dados analisado pode até exceder o limite de memória da capacidade, já que apenas o necessário é carregado. Além disso, os dados novos ficam disponíveis rapidamente, pois o modelo é sincronizado com a fonte automaticamente ou por reframing programático.
As duas variantes do Direct Lake
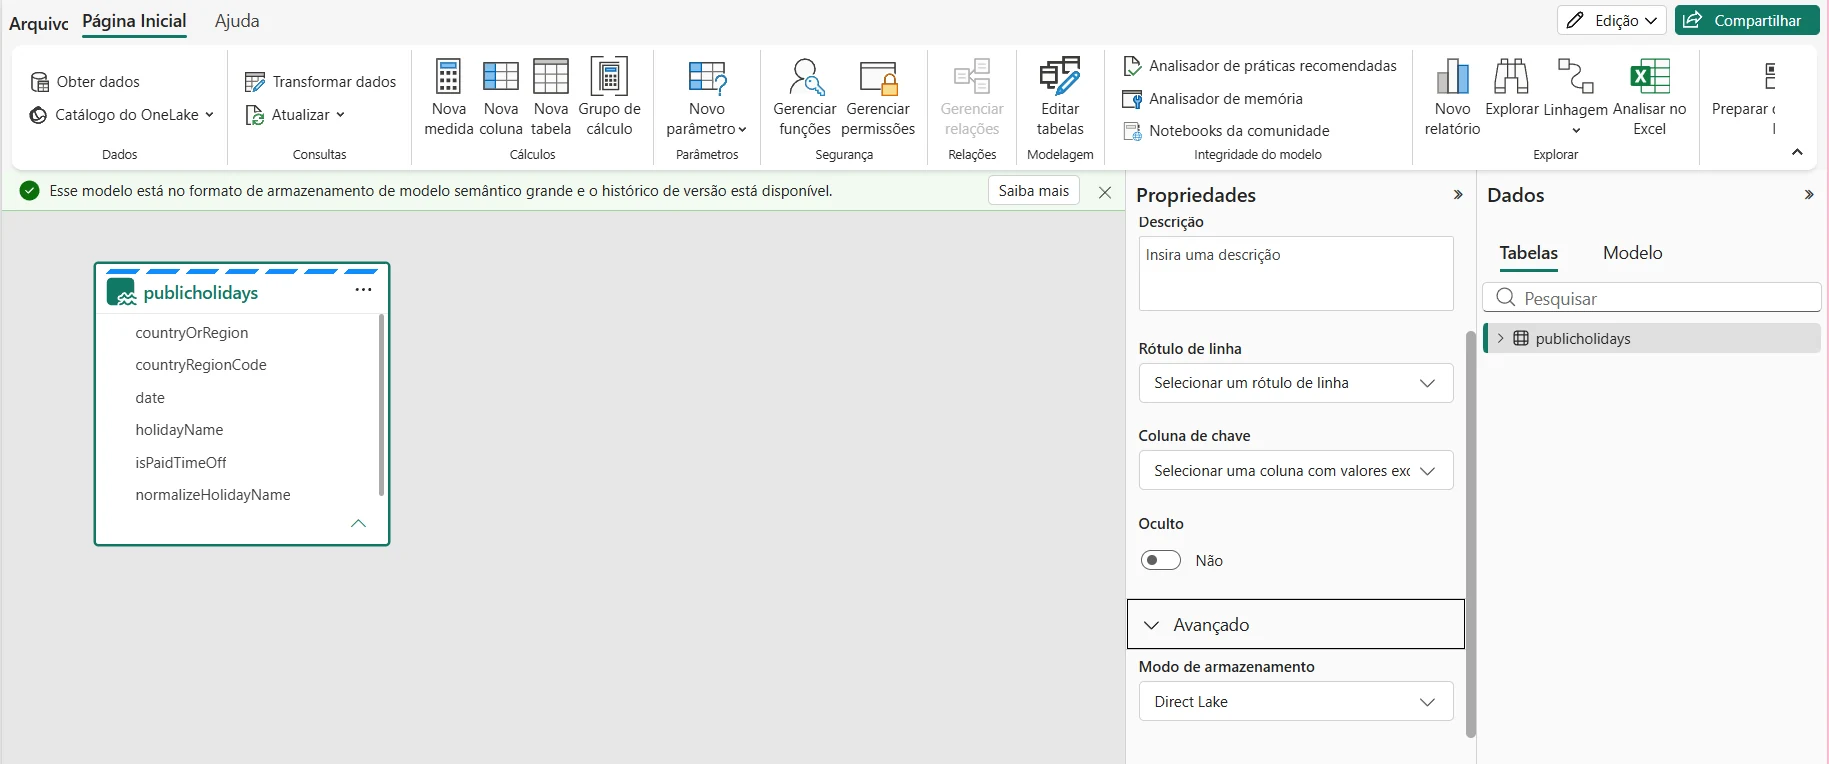
- Direct Lake no OneLake: usa dados de uma ou mais fontes Fabric com tabelas Delta e não recorre ao DirectQuery. Permite adicionar tabelas Import de outras fontes (modelo composto).
- Direct Lake no SQL (endpoint de análise): usa uma única fonte Fabric e o endpoint de análise SQL para descobrir tabelas, views e verificar permissões. Pode recorrer ao DirectQuery (fallback) quando não consegue carregar o dado diretamente da tabela Delta, por exemplo, em views SQL.
Quando usar o Direct Lake
O principal caso de uso são projetos de análise conduzidos pela TI, com arquitetura centrada no lago de dados (lakehouse), em que há ou se espera acumular grandes volumes no OneLake e é importante ter carga rápida em memória, atualizações frequentes, uso eficiente da capacidade e consultas rápidas. É uma ótima escolha para a camada ouro (gold) da arquitetura medalhão.
Import e DirectQuery continuam relevantes. O Import, por exemplo, atende bem o analista de autoatendimento que precisa de agilidade e transformações em Power Query sem depender da TI. A própria Microsoft recomenda criar uma prova de conceito (POC) para validar se o Direct Lake é a solução certa antes de adotá-lo.
Passo a passo: criando um modelo Direct Lake
O fluxo geral para otimizar o acesso a uma base grande é o seguinte:
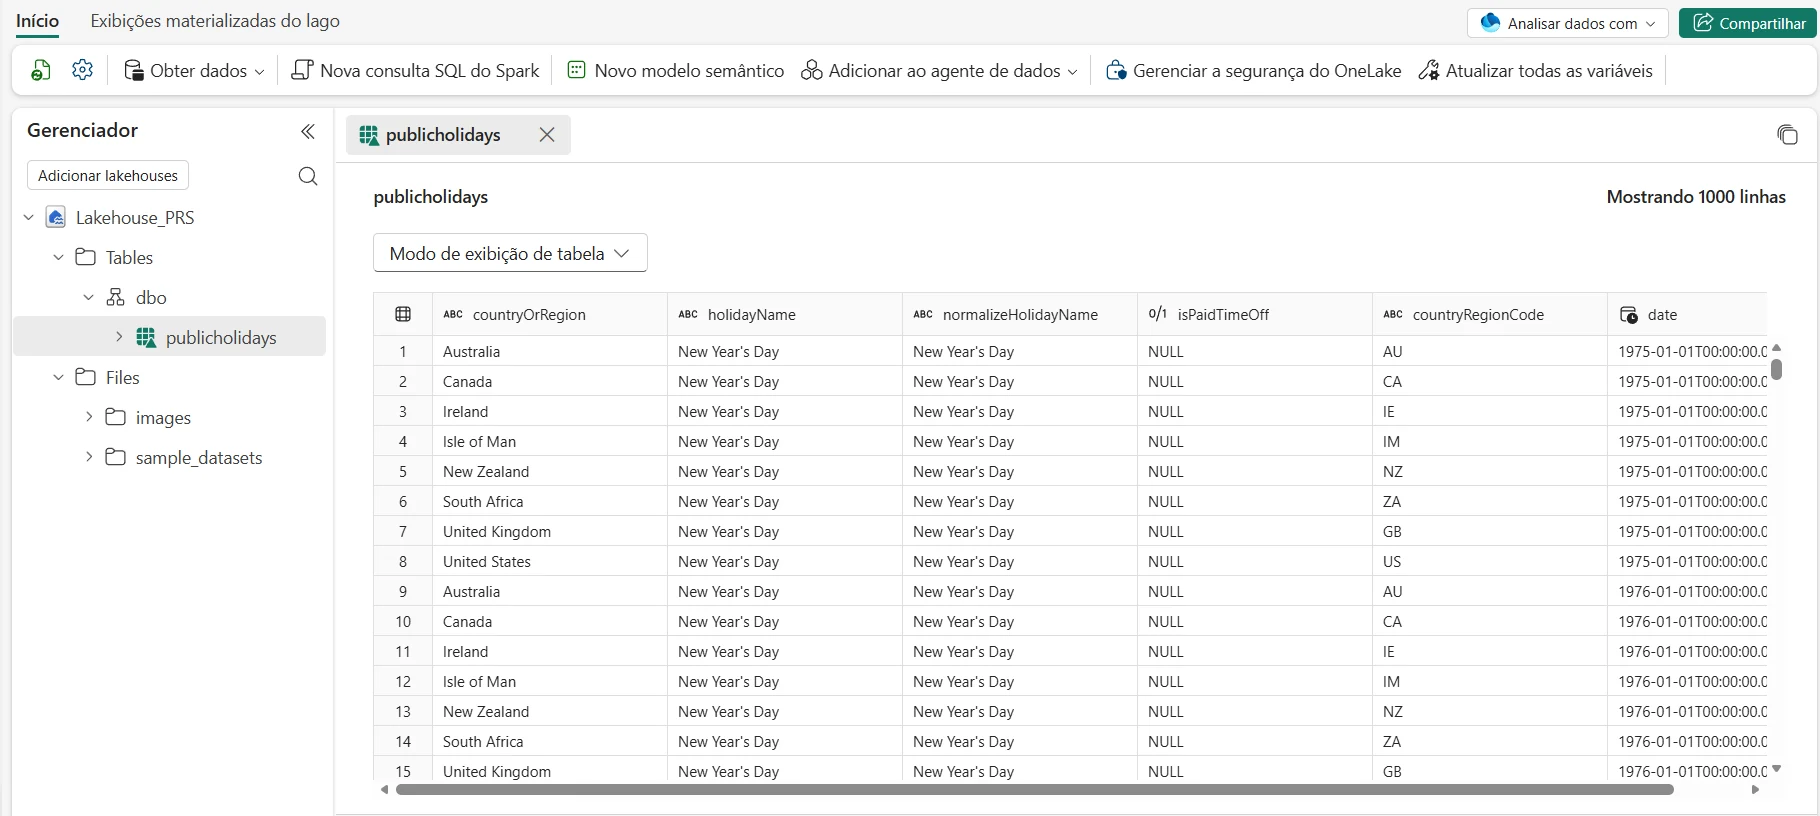
- Leve os dados ao OneLake em formato Delta: use um Lakehouse (ou Warehouse) e carregue os dados com Spark, pipelines, Dataflow Gen2 ou T-SQL. Dados de fontes externas podem ser acessados por atalhos (shortcuts) ou espelhamento.
- Prepare e otimize as tabelas Delta: a performance do Direct Lake depende de tabelas bem ajustadas (V-Order, tamanho adequado de grupos de linhas e poucos arquivos pequenos).
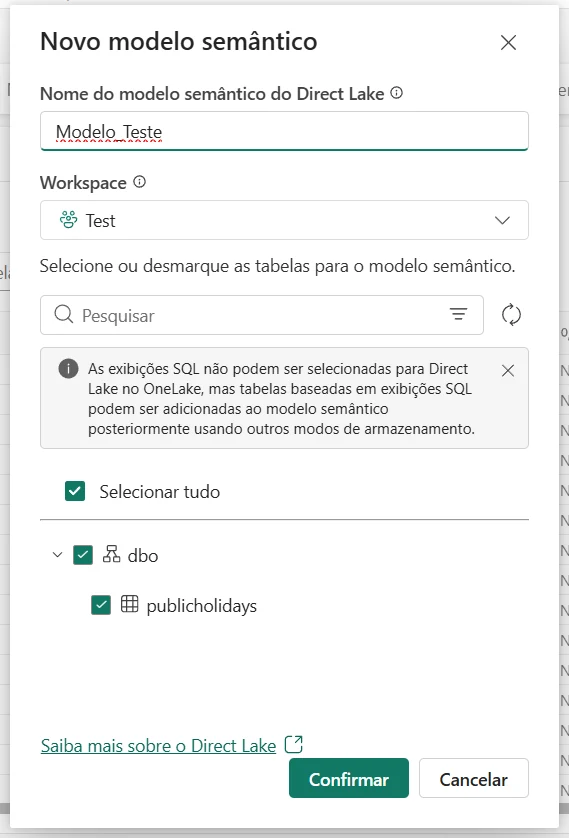
- Crie o modelo semântico: a partir do Lakehouse, crie um novo modelo semântico e selecione as tabelas que farão parte dele.
- Modele: defina relações, medidas DAX e segurança (RLS/OLS).
- Crie os relatórios: conecte o relatório ao modelo e publique para os usuários.
Atualização do modelo (reframing)
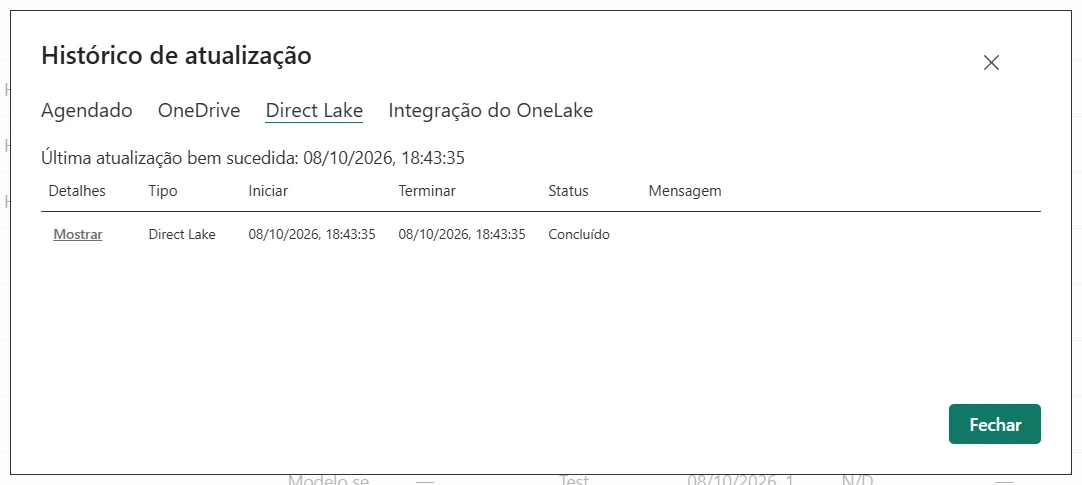
Para refletir novos dados, o modelo precisa ser "reenquadrado". Isso pode ocorrer automaticamente, quando as atualizações automáticas estão habilitadas, ou de forma programática, ao final do pipeline de carga, garantindo que o relatório só enxergue os dados quando eles estiverem consistentes. No histórico de atualizações do portal do Fabric, a aba Direct Lake registra as atualizações (enquadramentos) e, principalmente, as falhas relacionadas ao Direct Lake. Na imagem abaixo, a atualização do modelo aparece como concluída em menos de um segundo, pois apenas metadados são processados.
Limites por SKU (guardrails)
Cada SKU do Fabric define limites que devem ser respeitados. Se ultrapassados, no Direct Lake no OneLake a atualização falha até que as tabelas sejam otimizadas; no Direct Lake no SQL, as consultas recorrem ao DirectQuery (mais lento). Alguns exemplos:
| SKU | Arquivos Parquet por tabela | Linhas por tabela (milhões) | Memória máxima (GB) |
|---|---|---|---|
| F2 a F8 | 1.000 | 300 | 3 |
| F32 | 1.000 | 300 | 10 |
| F64 | 5.000 | 1.500 | 25 |
| F128 | 5.000 | 3.000 | 50 |
| F256 | 5.000 | 6.000 | 100 |
| F512 | 10.000 | 12.000 | 200 |
| F1024 ou superior | 10.000 | 24.000 | 400 |
Os limites de arquivos, grupos de linhas e linhas são avaliados por consulta. Por isso, otimizar as tabelas Delta (menos arquivos, maiores e bem organizados) evita ter que escalar desnecessariamente para um SKU maior.
Considerações e limitações importantes
- Não há suporte a tipos complexos de tabela Delta, nem a colunas binárias e GUID. Converta-os para texto ou outro tipo suportado.
- Colunas do lado "um" de uma relação devem conter valores únicos; duplicidades fazem as consultas falharem.
- Valores de texto são limitados a 32.764 caracteres Unicode.
- O workspace do modelo precisa estar na mesma região da fonte de dados (use atalhos como alternativa).
- Não há suporte a gateways: o Direct Lake usa apenas conexões de nuvem.
- No Direct Lake no OneLake, o RLS definido no endpoint SQL não é aplicado; use a segurança do modelo semântico (RLS/OLS), de preferência com identidade fixa.
As funcionalidades do Direct Lake evoluem rapidamente. Consulte a documentação oficial da Microsoft para a lista mais recente de limitações.
Direct Lake e Power BI Embedded
Modelos Direct Lake podem ser usados com Power BI Embedded, com um requisito técnico: a incorporação exige um token de incorporação V2. Se a aplicação usa uma entidade de serviço, é necessário usar uma conexão de nuvem com identidade fixa.
Como o Direct Lake roda sobre a capacidade Microsoft Fabric, o Portal BI Embedded simplifica a operação: a capacidade é provisionada e gerenciada automaticamente, com auto-suspend inteligente quando não há uso, e o custo é distribuído entre os usuários. Para preparar os dados que alimentam o modelo, veja também o Dataflow Gen2.
Perguntas frequentes sobre o Direct Lake
É um modo de armazenamento de tabelas de modelos semânticos do Power BI, disponível no Microsoft Fabric. Ele carrega rapidamente na memória os dados de tabelas Delta do OneLake, e as consultas são processadas pelo mecanismo VertiPaq, com desempenho comparável ao modo Import, sem a necessidade de copiar todos os dados a cada atualização.
No modo Import, a atualização replica os dados e cria uma cópia inteira em cache, o que pode levar tempo e consumir muitos recursos. Na atualização do Direct Lake (enquadramento ou framing) apenas metadados são copiados, o que leva normalmente alguns segundos, e os dados são carregados na memória sob demanda.
Em cenários com grandes volumes de dados no OneLake, ele costuma ser a melhor opção, pois o DirectQuery envia cada consulta à fonte de dados e tende a ser mais lento. O Direct Lake no SQL ainda pode recorrer ao DirectQuery em alguns casos (como views SQL); o Direct Lake no OneLake não faz esse fallback.
Sim. Os modelos semânticos Direct Lake exigem uma assinatura de capacidade Fabric (SKUs da série F ou Power BI Premium por capacidade). Com o Portal BI Embedded, a capacidade Fabric é provisionada e gerenciada automaticamente, ligando e desligando conforme a demanda.
Sim, com um requisito: é necessário usar um token de incorporação V2. Se você usa uma entidade de serviço, deve usar uma conexão de nuvem com identidade fixa.
O Direct Lake combina o melhor de dois mundos: a velocidade do Import e a escala do lago de dados, sem o custo de copiar grandes volumes a cada atualização. Para empresas com bases extensas, ele reduz o tempo de atualização, diminui a latência dos dados e aproveita melhor a capacidade Fabric. Se quiser avaliar a adoção, comece por uma prova de conceito com uma tabela de fatos grande.